視頻分鏡提示詞Skill,詳細製作過程分享!
整理版優先睇
阿真分享點樣由零砌一個「劇本轉視頻分鏡提示詞」Skill:先定用途、輸入同交付,再用七步流程同四層結構鎖住格式,最後測試封裝成可重用工具。
呢篇係阿真喺 WeChat 分享嘅實戰整理:佢之前做過一個「劇本轉視頻分鏡提示詞」Coze Skill,今次唔係教單句 prompt,而係交代點樣由零砌一個可重用 Skill。作者想解決嘅問題好具體:短劇劇本要變成角色設定、場景設定、逐鏡分鏡同一致性檢查,如果每次靠人手寫提示詞,格式同質素都會散,亦好難批量交付。
文章主線係先定清楚「用嚟做咩、輸入咩、輸出咩」,再拆成解析、角色提取、場景分析、分鏡生成、提示詞優化、一致性檢查同導出,之後用統一表格同欄位鎖住格式。作者將 Skill 分成 SKILL.md、scripts/、references/、assets/ 四層,並示範用 AI 分段生成腳本、規範同模板,最後用 2-3 份劇本測試再封裝。
整體結論係:Skill 唔係寫得越複雜越好,而係要有一條清楚主線、穩定輸出格式同可維護嘅分工;規則放 references、執行放 scripts、交付外觀放 assets,改動時就只改相關部分。文章亦提醒,輸入太簡略會令走向不可控,測試同逐個模塊修改係必要步驟。
- 核心結論:整 Skill 要先鎖定用途、輸入同最終交付,再用固定流程同欄位防止輸出越做越散。
- 方法主線:劇本解析→角色提取→場景分析→分鏡生成→提示詞優化→一致性檢查→導出,七步唔建議跳。
- 結構差異:SKILL.md 管定位同入口,scripts/ 負責執行,references/ 放規則術語,assets/ 放 CSV、HTML 等交付模板。
- 維護啟發:規則變就改 references,邏輯變就改 scripts,唔好每次都重寫成個 Skill;改之前要叫 AI 只改指定檔案同講清驗收。
- 可行動點:先用一份劇本跑通全流程,再用 2-3 份不同劇本測字段、鏡頭同提示詞質素,最後封裝成可下載 Skill。
劇本轉視頻分鏡提示詞 Skill(阿真原版)
完整 Skill 文件可喺飛書文檔下載,內含 SKILL.md、scripts/、references/、assets/,適合作為改寫基礎。
Coze Skill 使用入口
阿真早前分享嘅「劇本生成分鏡」Skill,可以直接喺 Coze 睇使用案例同觸發方式。
從零構建 Skill 的主提示詞
文章示範用 15 步規格要求 AI 定義流程、輸入、產出、統一字段、生成 references/assets、腳本、測試同封裝;重點係不可跳步、不可合併步驟。
唔係寫一句 prompt,而係砌一條可交付生產線
阿真之前做過一個「劇本轉視頻分鏡提示詞」Coze Skill,今次借住復工寫一篇輕鬆版製作筆記,講清楚個 Skill 由概念到封裝點砌。
由單句 prompt 升級到可重用 Skill
作者想解決嘅唔係「點寫一條好 prompt」,而係短劇劇本要批量變成角色設定、場景設定、逐鏡分鏡同一致性報告時,點樣保持格式同質素穩定。
批量交付時最怕格式同質素漂移
- 輸入:短劇劇本檔案,支援 Word、PDF、TXT、Markdown、Final Draft .fdx;亦可加角色圖、風格圖、畫幅同時長要求。
- 輸出:角色設定、場景設定、完整分鏡提示詞、一致性檢查報告,同埋 Markdown/JSON/CSV/Excel 等導出檔。
- 定位:將劇本智能拆解成可直接餵畀 AI 視頻生成嘅中文提示詞體系,支援批量處理同多格式導出。
四層骨架:入口、執行、規則、模板分開擺
完整 Skill 唔止一個 SKILL.md;阿真將它拆成四層,等每個部分有清楚責任。
四層分工:入口、執行、規則、模板
- SKILL.md:定義定位、觸發方式、整體流程、輸入要求同輸出目標,係成個 Skill 嘅入口。
- scripts/:放 Python 自動化腳本,負責解析、提取、生成、優化、校驗同導出,真正令流程跑起來。
- references/:放術語、模板、規則同方法,類似知識庫,保證結果統一、可解釋、可複用。
- assets/:放可直接套用嘅 HTML/CSV/JSON 模板同速查表,加快交付同統一排版。
SKILL.md 係入口,唔係萬能文件
scripts 負責做,references 負責講點解,assets 負責交付外觀
呢種分法嘅好處係改動邊層就只碰邊層:規則變改 references,流程邏輯變改 scripts,交付格式變改 assets,唔會全部炒埋一碟。
改動邊層就只碰邊層
由主線到落地:七步流程同十五步施工
作者先定一條主線:劇本解析 → 角色提取 → 場景分析 → 分鏡生成 → 提示詞優化 → 一致性檢查 → 導出。呢條線係默認工作流程,唔建議跳步或者合併。
七步流程係骨架,唔好一開始就跳去寫腳本
- 1 劇本解析:識別場次、場景描述、角色對白、動作指示,估算場次時長,輸出結構化 JSON。
- 2 角色提取:抽年齡、性別、體型、五官、髮型、膚色、服裝、氣質同標誌道具,形成可直接生圖嘅角色提示詞。
- 3 場景分析:拆室內外、地點、空間、道具、光線、色調、氛圍、天氣同時間,做全片視覺基礎。
- 4 分鏡生成:按場次拆鏡頭,最少有建立鏡頭、角色出場同對話鏡頭,每鏡要有景別、構圖、運鏡、時長同提示詞。
- 5 提示詞優化:統一術語、去重、補質量詞,令輸出更適合視頻模型,唔好每條風格都散。
- 6 一致性檢查:交叉比對角色跨鏡頭、場景連續性同光影風格,輸出問題、修復建議同可複用提示詞。
- 7 導出:支援 JSON、CSV、Markdown、Excel 或 HTML,按場次、角色、場景分類交付。
實際施工可以分前期、中期、後期:前期定標準,中期優化功能模塊,後期測試同封裝。作者亦提到,AI 有時可以一次過執行多個要求,再按效果逐輪調整。
前期定標準、中期優化模塊、後期測試封裝
你是一個 Skill 開發助手,幫我從零構建一個「劇本轉視頻分鏡提示詞」Skill。
請按以下規格和順序執行,不可跳步,不可合併步驟。

【第一步:工作流程定義】
劇本解析 → 角色提取 → 場景分析 → 分鏡生成 → 提示詞優化 → 一致性檢查 → 導出。
如果用戶沒有特別要求改變流程,永遠執行完整的七步。

【第二步:輸入規格定義】
支持 txt、md、docx、pdf、fdx。
最低可運行輸入:一個劇本文檔,甚至一段話或一句核心概念;要先提醒用戶信息有限,風格一致性和走向可能不可控。
推薦輸入:劇本 + 角色參考圖 + 風格參考圖 + 目標畫幅比例 + 目標時長 + 視覺風格關鍵詞。

【第三步:最終產出定義】
角色設定文檔、場景設定文檔、完整分鏡提示詞表、一致性檢查報告、導出文件(CSV/Markdown/Excel/HTML)。

【第四步:統一結構規範】
分鏡提示詞表按「第 X 幕第 X 場景」組織,字段包括:
鏡頭編號、景別、畫面描述、構圖、運鏡、光線、色調、氛圍、時長、鏡頭角度、提示詞。

【第五步至第十五步】
references 規範文檔 → assets 模板 → 劇本解析腳本 → 角色提取腳本 → 場景分析腳本 → 分鏡生成腳本 → 提示詞優化腳本 → 一致性檢查腳本 → 導出腳本 → 測試 2-3 份劇本 → 封裝 SKILL.md。測試同維護:每次只改一個位,先講驗收
完成初版之後,唔好即刻當佢穩定。作者建議用 2-3 份不同劇本跑全流程,重點睇字段有冇缺失、鏡頭有冇正確生成、提示詞有冇跟 references 規範。
用 2-3 份不同劇本跑全流程
字段、鏡頭、提示詞三層驗收
- 字段檢查:角色、場景、分鏡表嘅欄位有冇漏,格式有冇前後不一致。
- 鏡頭檢查:有冇建立鏡頭、角色出場同對話鏡頭,景別同運鏡係咪合理。
- 提示詞檢查:有冇跟術語、情緒詞庫同質量詞規範,風格會唔會每條都散。
- 問題定位:發現問題就只改對應腳本或規範文件,唔好連無關檔案一齊改。
後期修改想省 token,最實用係叫 AI 每次只做一件小事:只改指定檔案、先找問題點、做最小改動,最後講清楚改咗邊幾行、影響乜、點驗證。
只改指定檔案、先找問題點、做最小改動
最後將目錄整理成 SKILL.md + scripts/ + references/ + assets/,再讓 AI 封裝同自己確認,就得到一個可以下載、安裝同重用嘅 Skill。
可直接拎走嘅資源同提示詞思路
文章尾段放咗原版 Skill 下載同 Coze 使用入口,亦推薦咗 @一澤Eze 嘅 Agent Skills 指南。想照住做,可以由原版 Skill 入手,再按自己嘅視頻風格改 references 同 assets。
先抄骨架,再換自己嘅風格規範
- 原版 Skill:可以喺飛書文檔下載完整文件,查看 SKILL.md、scripts、references 同 assets 點樣組織。
- Coze Skill:可以直接喺 Coze 睇使用案例,理解輸入劇本後點樣生成分鏡提示詞。
- 提示詞思路:先寫用途、輸入、輸出同流程,再要求 AI 生成獨立腳本;唔滿意就只針對某一步優化提示詞。
作者亦提到,references 同 assets 最好經過多輪對話優化,唔好一次過生成就當完成;滿意嘅模板先放入去,再要求腳本按指定路徑調用。
references 同 assets 要經多輪對話優化
嗨大家好!我係阿真!新年快樂!
好耐冇見,個假放到我爽曬,返嚟就搏命做嘢。今日呢篇會輕鬆啲,我先做返少少熱身復健,寫個簡單啲、關於影片提示詞 Skill 製作嘅內容。
上次寫 Coze Skill 嘅時候,我曾經分享過一個劇本生成分鏡嘅 Skill,大家可以直接喺 Coze 用,連結喺:
https://www.coze.cn/?skill_share_pid=7596234767713173538
亦可以直接下載 Skill 文件,文件附件連結我放咗喺文章最後嘅飛書雲文檔連結度。原本個 Skill 做得比較通用,大家可以喺我個基礎上面改。
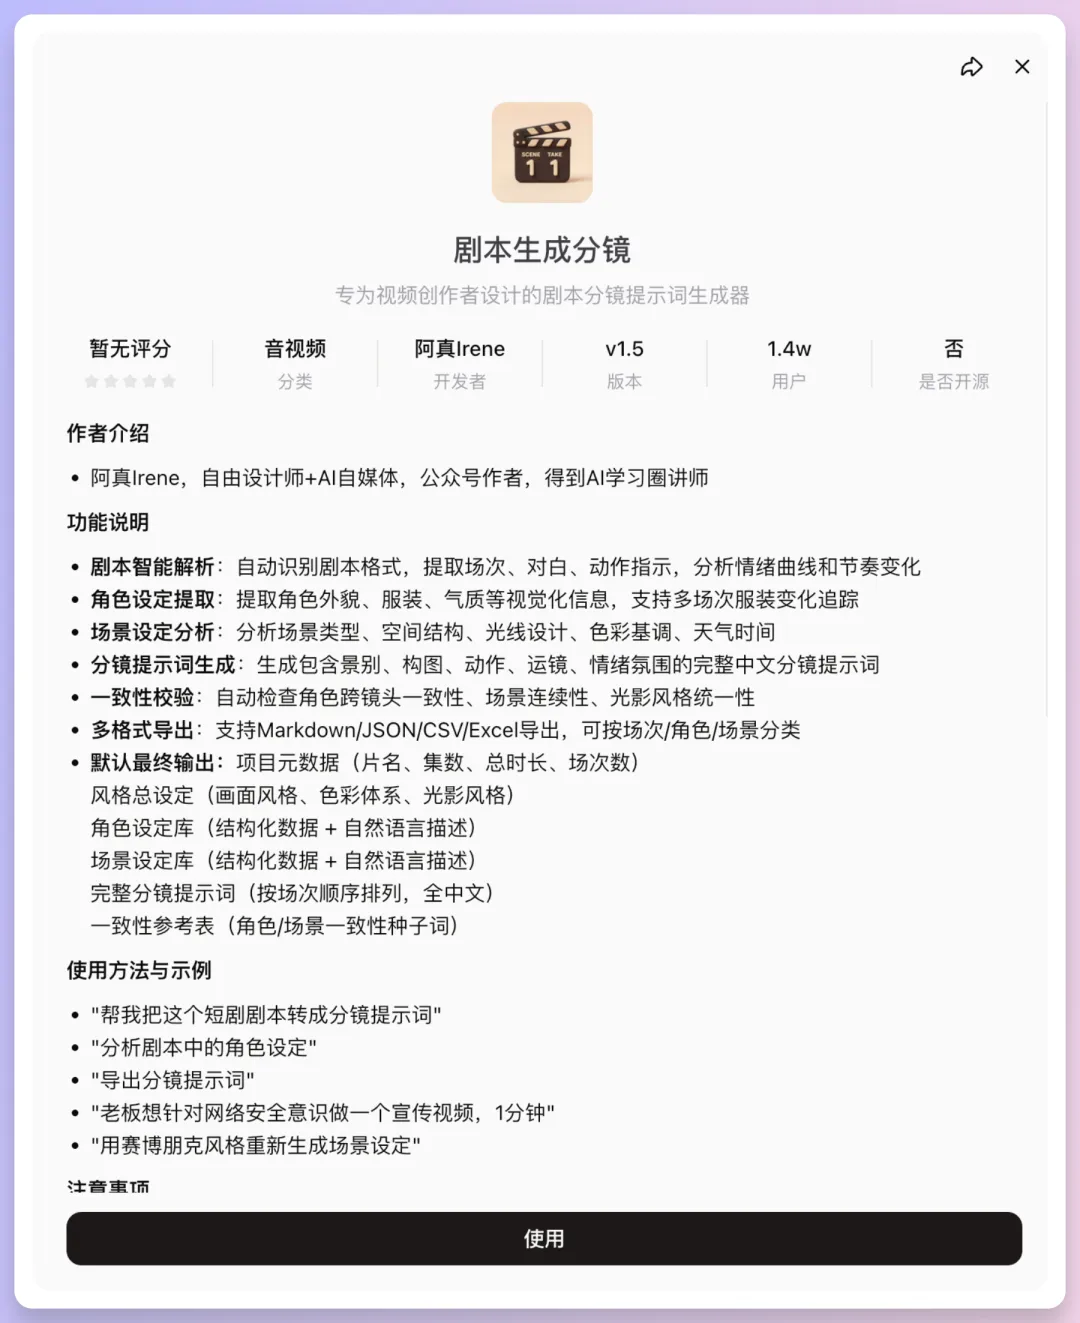
至於佢點用,我喺 Coze Skill 都寫過,就唔再贅述,喺上面呢個 Coze 技能度都可以睇到使用案例:
或者下載最後嘅 Skill 文件,上載到支援 Skill 使用嘅工具度用都得:
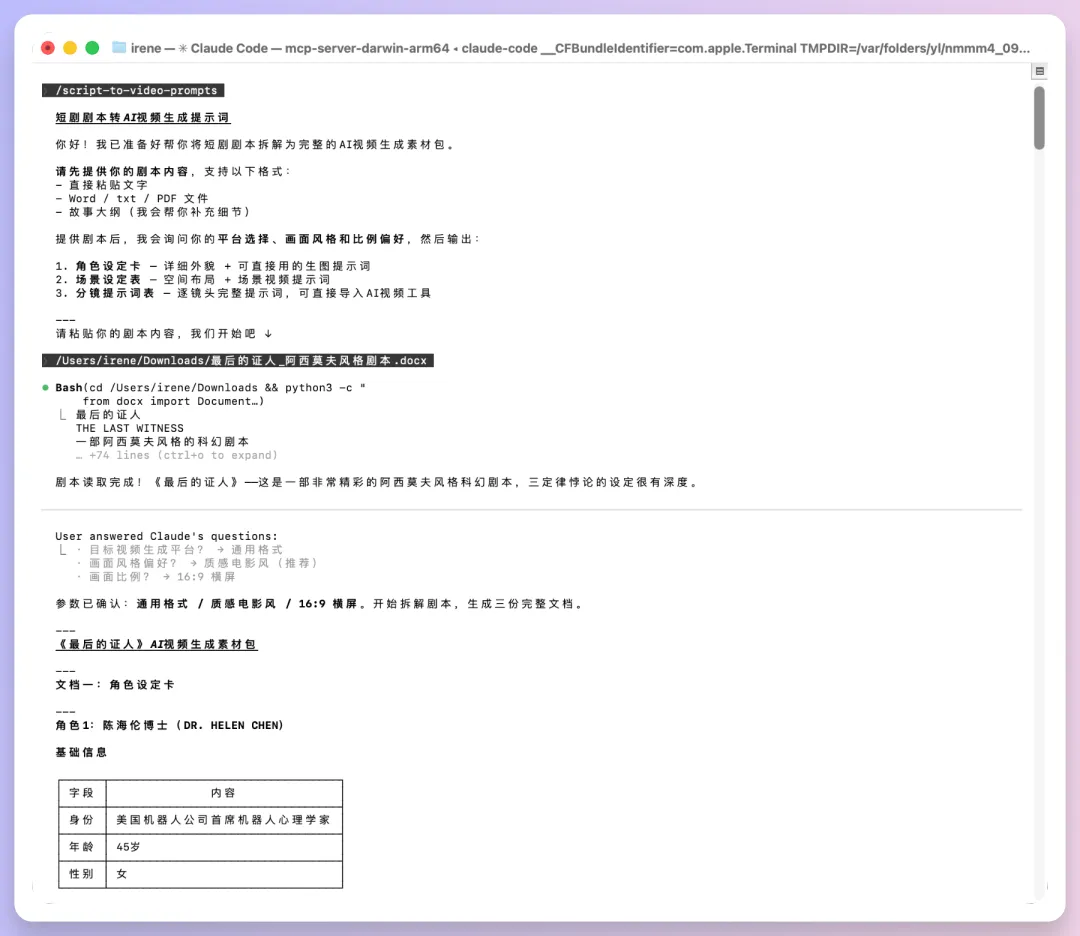
今日就分享呢種 Skill 係點做。
簡單講,思路就係:首先諗清楚要做咩,然後將任務一步一步拆細,先有整體結構,再填充枝葉。
完整嘅 Skill 結構係咁:
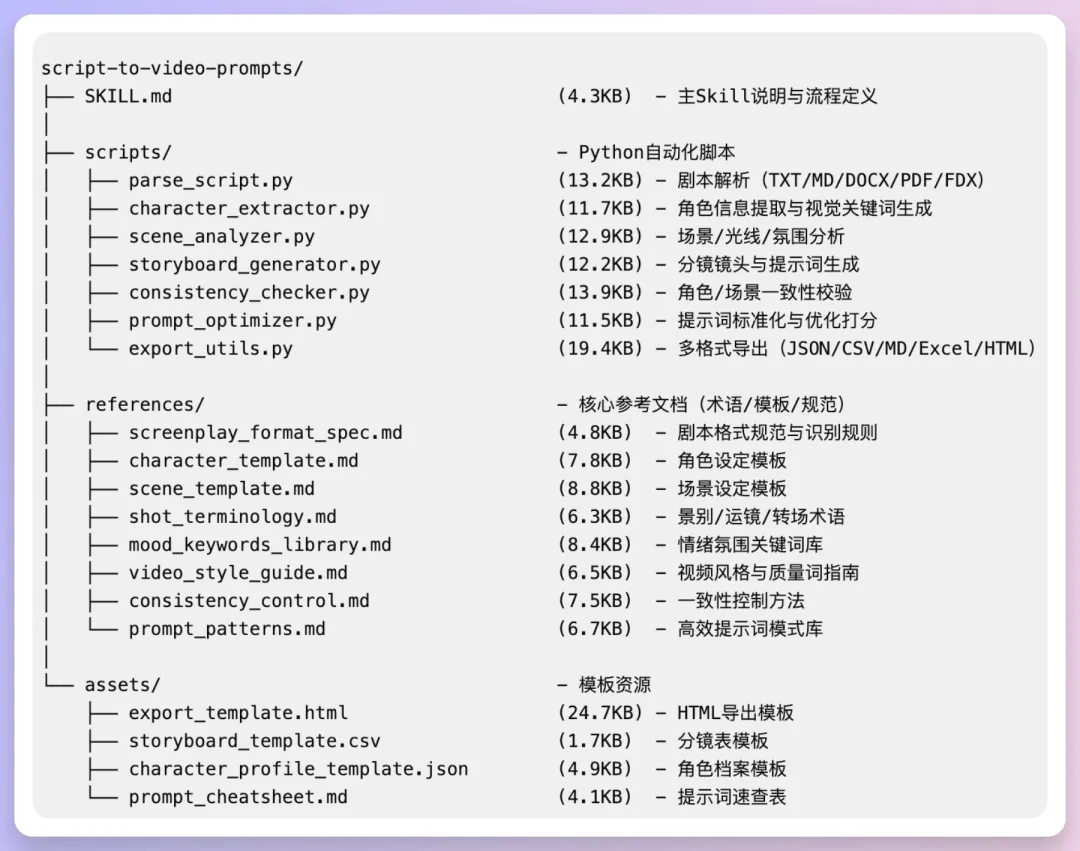
上面幾個結構嘅說明👇
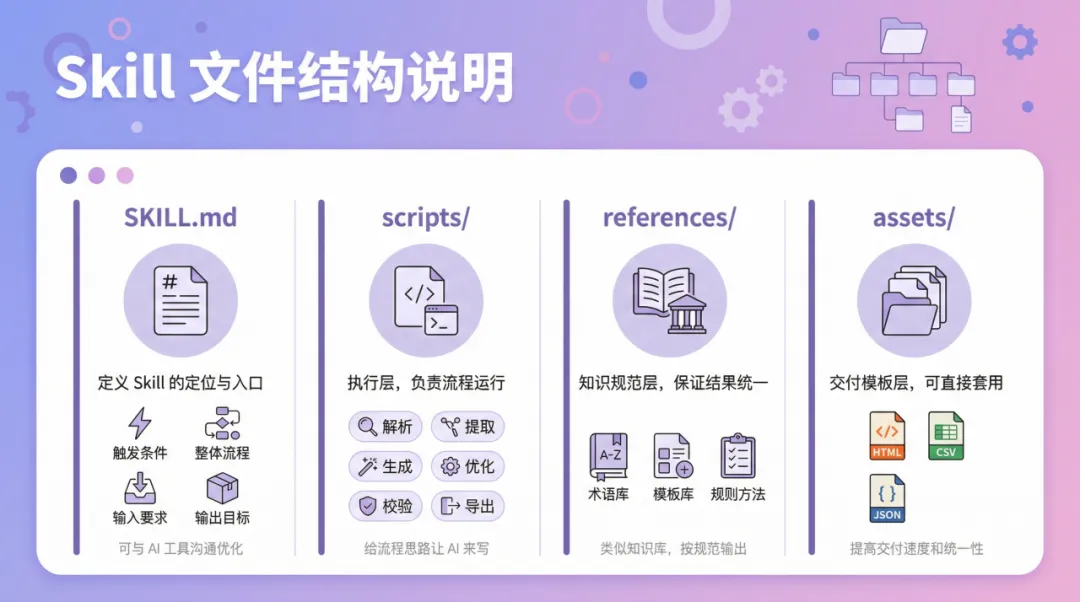
SKILL.md:定義呢個 Skill 嘅定位同入口,講清楚點觸發、整體流程、輸入要求、輸出目標。呢個可以自己寫個雛形,再同 AI 工具溝通同優化。
scripts/:執行層,呢度放 Python 自動化腳本,佢負責將流程真正跑起上嚟(解析、提取、生成、優化、匯出等)。呢個可以畀個流程思路 AI 去寫。
references/:知識規範層,提供術語、模板、規則同方法,保證結果統一、可解釋、可複用。類似知識庫,可以將平時用開嘅格式規範放埋入去,並且喺需要生成某個具體部分嘅內容時,要求佢按照呢個規範輸出。
assets/:交付模板層,提供可以直接套用嘅資源文件(例如 HTML/CSV/JSON 模板同速查表)。佢可以提高交付速度同統一性,避免每次都由零開始搞格式同排版。
下面係 SKILL.md 文件,完整 Skill 內容大家可以去文章最後嘅分享連結下載睇:
---
name: script-to-video-prompts
description: 短劇劇本轉視頻提示詞生成器。將用戶上傳的短劇劇本文檔智能拆解為可直接用於AI視頻生成的完整中文提示詞體系。輸出包括:角色設定提示詞、場景設定提示詞、逐鏡頭分鏡提示詞。支持批量處理、多格式導出、一致性校驗。當用戶說"劇本轉視頻提示詞"、"拆解劇本生成分鏡"、"短劇轉視頻"、"批量生成分鏡提示詞"、"劇本可視化"時觸發。
---
# 短劇劇本轉視頻提示詞生成器
將短劇劇本文檔智能拆解為可直接用於AI視頻生成的完整中文提示詞體系,支持自動化批量處理。
## 用戶輸入
- 短劇劇本文檔(Word/PDF/TXT/Markdown/Final Draft .fdx)
- 可選:風格參考圖片、角色參考圖片、已有角色設定表
## 工作流程
### 1. 劇本智能解析
使用 `scripts/parse_script.py` 解析劇本:
- 自動識別劇本格式(標準編劇格式/自由格式)
- 提取場次(Scene)、場景描述(Action)、角色對白(Dialogue)、動作指示(Parenthetical)
- NLP分析:情緒曲線、節奏變化、畫面密度
- 自動生成場次時長估算
### 2. 角色設定提取
使用 `scripts/character_extractor.py` 提取角色信息:
- 基礎外貌(年齡、性別、體型、五官特徵)
- 髮型髮色、膚色
- 服裝造型(支持多場次服裝變化追蹤)
- 角色氣質/性格的視覺化表達
- 標誌性道具/配飾
輸出格式參考 [references/character_template.md](references/character_template.md)
### 3. 場景設定分析
使用 `scripts/scene_analyzer.py` 分析場景:
- 場景類型(室內/室外、具體地點)
- 空間結構、關鍵道具佈置
- 光線設計(光源類型、方向、強度、色温)
- 色彩基調、視覺氛圍
- 天氣/時間/季節
輸出格式參考 [references/scene_template.md](references/scene_template.md)
### 4. 分鏡提示詞生成
使用 `scripts/storyboard_generator.py` 生成分鏡:
- 鏡頭編號(場次-鏡號)
- 景別(大特寫/特寫/中近景/中景/中遠景/遠景/大遠景),詳見 [references/shot_terminology.md](references/shot_terminology.md)
- 畫面構圖(三分法位置、視線引導)
- 角色動作、表情、站位
- 運鏡方式(固定/推/拉/搖/移/跟等),詳見 [references/shot_terminology.md](references/shot_terminology.md)
- 情緒氛圍關鍵詞,詳見 [references/mood_keywords_library.md](references/mood_keywords_library.md)
- 建議時長(秒)
- 轉場方式
### 5. 一致性校驗
使用 `scripts/consistency_checker.py` 校驗:
- 角色跨鏡頭一致性控制
- 場景連續性檢查
- 光影風格統一性校驗
- 詳見 [references/consistency_control.md](references/consistency_control.md)
### 6. 導出
使用 `scripts/export_utils.py` 導出:
- 支持格式:Markdown/JSON/CSV/Excel
- 支持按場次/角色/場景分類導出
- 可生成可視化分鏡腳本
## 輸出結構
```
一、項目元數據
   - 片名、集數、總時長、場次數
二、風格總設定
   - 畫面風格、色彩體系、光影風格
三、角色設定庫
   - JSON結構化數據 + 自然語言描述
四、場景設定庫
   - JSON結構化數據 + 自然語言描述
五、完整分鏡提示詞
   - 按場次順序排列,提示詞全部使用中文
六、一致性參考表
   - 角色/場景一致性種子詞
```
## 參考文件
### scripts/(自動化腳本)
- `parse_script.py` - 劇本解析器
- `character_extractor.py` - 角色信息提取
- `scene_analyzer.py` - 場景分析
- `storyboard_generator.py` - 分鏡生成
- `consistency_checker.py` - 一致性校驗
- `export_utils.py` - 多格式導出
- `prompt_optimizer.py` - 提示詞優化
### references/(規範文檔)
- `screenplay_format_spec.md` - 劇本格式規範
- `character_template.md` - 角色設定模板
- `scene_template.md` - 場景設定模板
- `shot_terminology.md` - 景別/運鏡術語詞典
- `mood_keywords_library.md` - 情緒氛圍關鍵詞庫
- `video_style_guide.md` 視頻風格指南
- `consistency_control.md` - 一致性控制指南
- `prompt_patterns.md` - 高效提示詞模式庫
### assets/(模板資源)
- `storyboard_template.csv` - 分鏡腳本CSV模板
- `export_template.html` - 可視化導出HTML模板
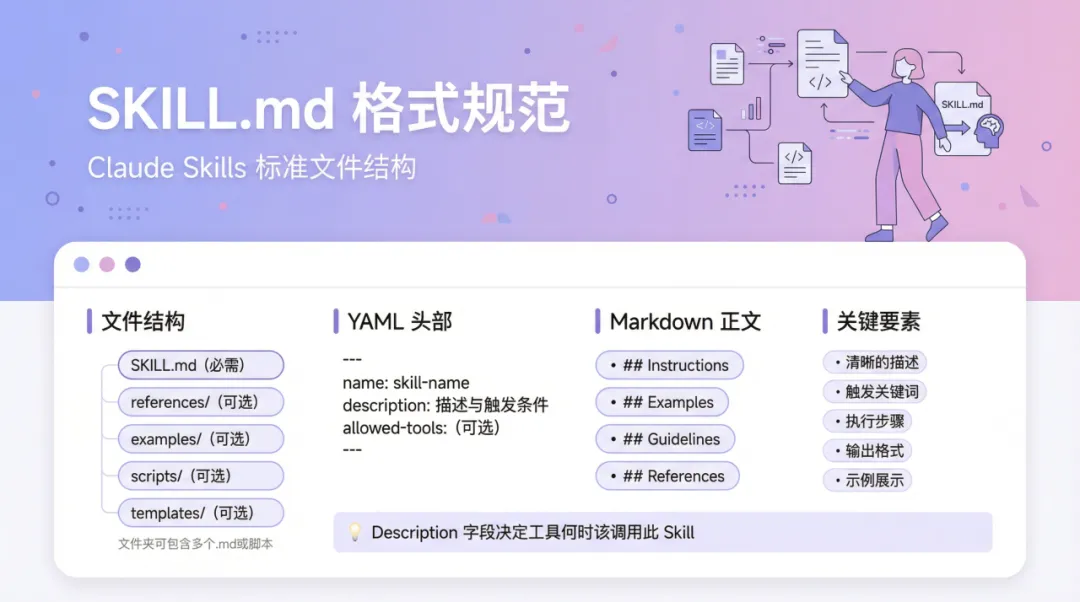
下方【文件結構】係 Skill 嘅文件結構,佢嘅文件結構入面必須有 SKILL.md 文件。YAML 頭部、Markdown 正文同關鍵要素係SKILL.md 格式規範。(可選)嘅部分唔係固定,可以係文件亦可以係文件夾,文件夾嘅命名都可以按自己要求嚟👇
製作 Skill 嘅時候,可以前期定標準,中期優化功能模塊,後期測試優化同封裝。下面係完整執行思路;注意下面雖然分咗步驟,但實際生成 Skill 嘅時候,佢都可以一次過執行曬所有要求,再按效果繼續優化調整。
前期:定標準
我希望呢個 Skill 嘅工作流程係咁:
劇本解析 → 角色提取 → 場景分析 → 分鏡生成 → 提示詞優化 → 一致性檢查 → 匯出。
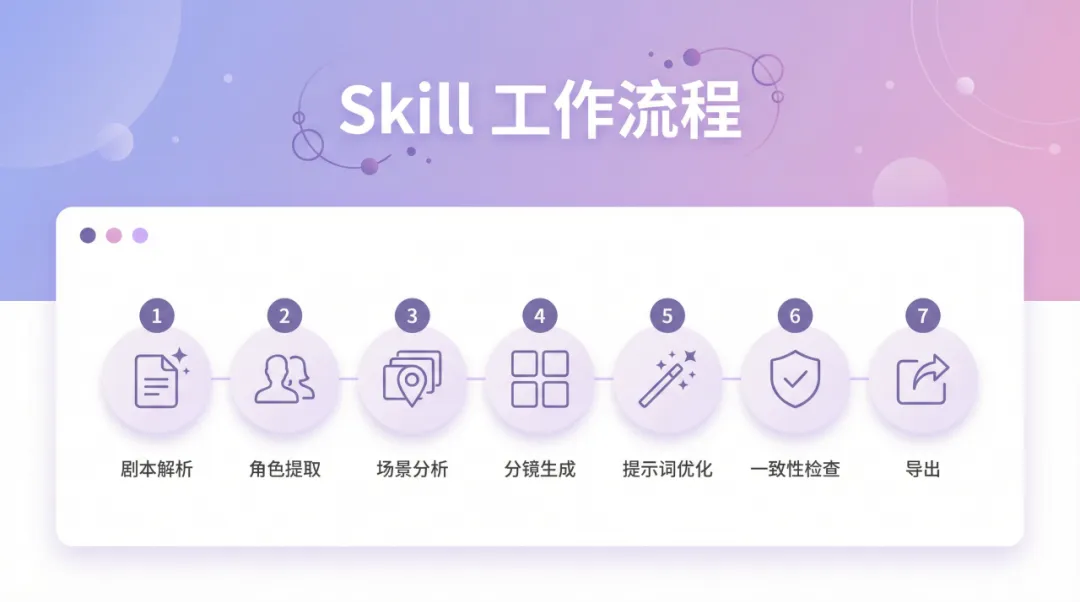
如果冇具體明確嘅工作流程要求,後面所有實現都會默認跟呢個規範。
確定支援邊啲輸入:例如 txt/md/docx/pdf/fdx。同時定義默認輸入係一個劇本文檔,亦可以係一段話甚至一句話,但咁樣嘅話,效果同內容走向可能會比較難控制;「推薦輸入」可以加角色圖參考、風格圖參考、畫幅要求、時長限制。
先寫清楚最終要產出邊啲文件:角色設定、場景設定、分鏡提示詞、一致性報告、匯出文件格式等。呢一步嘅作用係防止中途越做越偏。
確定每一步嘅輸入輸出係咩樣。我希望佢輸出嘅分鏡表係咩樣、希望佢輸出嘅角色設計提示詞格式係咩樣等等。呢一步好關鍵,每個輸出項嘅欄位先定好,再叫 AI 按要求輸出,後面就唔會亂。
例如我希望完整嘅分鏡提示詞表係按照第 X 幕第 X 場景,每個場景嘅提示詞表包含鏡頭編號、景別、畫面描述、構圖、運鏡、光線、色調、氛圍、時長、鏡頭角度、提示詞等。咁我可以自己做,或者叫 AI 生成一個咁樣統一嘅表格模板;如果本身有呢類模板,亦可以直接放埋入去。後面每個腳本都讀寫呢個模板,並且按照呢個格式輸出,咁就唔會唔同幕同場景之間格式互相對唔上。
可以製作模板放喺 assets 入面,等 AI 生成嘅腳本參考呢啲模板規範去生成。
中期:優化功能模塊
references 入面存放術語同模板。
整個提示詞嘅規則可以輸出成獨立文檔,例如劇本格式規範、鏡頭術語、情緒詞庫、提示詞模板、一致性指南等。咁樣會更方便修改同規範指定方向嘅文檔內容。其他人睇嘅時候,亦會知道點解要咁做。
assets 入面存放可複用模板內容。
例如:分鏡 CSV 模板、角色提示詞模板、HTML 模板、速查表等等。咁每次新項目都可以直接複用,唔使重做排版同欄位。
references 同 assets 入面嘅內容,建議分開生成、優化,輸出文件之後放埋入去,再畀指定路徑後續腳本調用。
接下來 7-12 幾個模塊都係腳本,呢啲都可以叫 AI 嚟寫。例如第 7 個嘅提示詞參考如下:
幫我生成腳本,用於把原始劇本內容(支持 `txt/md/docx/pdf/fdx`)解析成結構化 JSON,要求自動識別並分類:場景標題(INT/EXT 或“第X場/場景X”)、角色名、對白、動作、轉場,並輸出中文字段:`標題`、`場景列表`、`全角色`、`全地點`、`總時長秒數`、`元數據`(含`場景數`、`角色數`、`地點數`),其中每個場景至少包含`場景編號`、`場景標題`、`地點`、`時間段`、`內外景`、`角色`;規則是“上一行是角色名則下一行優先判定為對白,否則判定為動作”,沒有場景標題時自動創建默認場景,空行跳過;重點先保證穩健性和通用性,不追求複雜算法,優先做到“任何劇本或任意文本內容都能讀入並形成場景列表”;支持通過命令行傳入文件路徑並輸出格式化 JSON,代碼儘量清晰、註釋簡單、依賴缺失時提示安裝。再簡單啲(自己直接寫),如果咁寫唔滿意,可以喺呢個基礎上面叫 AI 優化提示詞:
生成一個通用劇本解析腳本,能讀取常見文本格式並智能分析內容,自動識別場景、角色、對白、動作和轉場,輸出清晰的結構化 JSON;要求優先保證穩定可用,即使輸入不規範也能自動補默認場景並正常返回結果。而家嘅 AI 工具都好醒目,我哋只要要求佢生成 Skill 嘅時候生成獨立腳本,佢就會自己生成。大多數時候都唔需要另外輸入提示詞。
7. 實現【劇本解析】模塊
將原始劇本變成結構化數據。識別同生成場景標題、角色名、對白、動作、轉場。
8. 實現【角色提取】模塊
由【7】嘅解析結果入面提取角色檔案:性別、年齡段、體型、髮型、關鍵詞。要求輸出時畀每個角色一段提示詞描述,後面分鏡可以直接用,調用都方便。
9. 實現【場景分析】模塊
由【7】每個場景入面提取地點、室內外、時間段、光線、氛圍,為每個場景生成一條基礎視覺提示詞。呢一層係全片視覺基礎,後面啲鏡頭都係喺佢上面疊加。
10. 實現【分鏡生成】模塊
按【7】嘅場景自動拆成鏡頭,至少包含:建立鏡頭、角色出場、對話鏡頭。每個鏡頭都要有編號、景別、運鏡、動作、時長、轉場、提示詞。先保證「有鏡頭可以用」,再逐步優化鏡頭嘅藝術性。
11. 實現【提示詞優化】模塊
將鏡頭提示詞做統一處理:術語標準化、去除重複提示詞、補品質詞(提升畫面質素同穩定性嘅萬能詞,例如高品質、電影感、清晰對焦呢類)。咁樣可以令輸出更適配影片模型,唔會每條風格都散。如果有時間,仲可以針對唔同風格,單獨製作唔同風格、唔同影片模型嘅提示詞規範表。
12. 實現【一致性檢查】模塊
檢查角色跨鏡頭提示詞、場景有冇跳變、光線有冇變化得太突兀等,輸出「問題 + 修復建議 + 複用規範提示詞」。
後期:測試優化同封裝
確認默認匯出格式,呢度我希望至少支援 JSON + CSV + Markdown。目標係畀唔同職能都可以直接睇同用。
用 2-3 份唔同劇本跑全流程。呢啲劇本可以 AI 生成,亦可以自己提供。
重點檢查:欄位有冇缺失、鏡頭係咪正確、提示詞係咪符合自己要求。
重要嘅部分可以單獨拎出嚟,補充獨立文檔同腳本;例如我對影片提示詞有指定要求,咁就可以單獨一個提示詞參考文檔(放喺 references)或者提示詞格式參考模板(放喺 assets),並要求腳本喺指定場景調用。
發現問題就叫 AI 針對對應模塊修改。
最後整理成清晰目錄,最簡單可以得一個 SKILL.md;複雜啲就可以加腳本、參考、模板等文件夾。我呢度嘅格式係:
SKILL.md + scripts/ + references/ + assets/。
呢個直接叫 AI 封裝 Skill,然後自己確認就可以。到呢一步,我哋就有一個比較完整嘅 Skill 喇。
梳理完全部步驟之後,就可以輸出一個完整提示詞,叫 AI 生成 Skill。需要詳細輸出嘅地方,可以單獨生成提示詞或模板之後放埋入去,要求腳本調用。
下面我放咗最初我嘅提示詞要求,後期對呢組提示詞做咗分部分嘅詳細優化,但我個 Claude 帳號被封咗,所以優化提示詞嘅過程冇咗😅;但大致邏輯思路就係上面咁,畀大家參考。另外,references/ 同 assets/ 入面嘅內容,亦建議透過對話多輪優化到自己滿意為止。
你是一個 Skill 開發助手,幫我從零構建一個「劇本轉視頻分鏡提示詞」Skill。請按以下規格和順序執行,不可跳步,不可合併步驟。

---
【第一步:工作流程定義】
這個 Skill 的工作流程是:先解析劇本結構,識別出幕、場景、對白和動作描述;然後提取所有角色,為每個角色生成設定;接着分析所有場景,為每個場景生成設定;再把每個場景拆解成具體鏡頭,生成分鏡提示詞表;之後對每條提示詞做優化,確保它足夠具體、包含必要的視覺參數、並且與角色和場景設定一致;然後做一致性檢查,交叉比對角色、場景與分鏡之間的偏差;最後按用戶要求的格式導出。不可以跳步,不可以合併步驟。如果用戶沒有特別要求改變流程,永遠執行完整的七步。
【第二步:輸入規格定義】
支持接收 txt、md、docx、pdf 和 fdx 格式的劇本文件。最低可運行的輸入是一個劇本文檔,哪怕只是一段話甚至一句核心概念也能啓動流程,但必須在開始前告訴用戶:當前輸入信息有限,後續生成內容的風格一致性和走向可能不完全可控,建議補充更多信息。推薦的輸入是劇本加上角色參考圖、風格參考圖、目標畫幅比例、目標時長、以及希望的視覺風格關鍵詞。用戶提供的參考圖永遠優先於自己的推斷。
【第三步:最終產出定義】
最終產出:一份角色設定文檔,包含每個角色的外貌、服裝、氣質關鍵詞和可用於 AI 生圖的完整提示詞;一份場景設定文檔,包含每個場景的空間描述、光線類型與方向、主色調和氛圍詞;一份完整的分鏡提示詞表,按照幕、場景、鏡頭三級結構組織;一份一致性檢查報告,標註角色和場景在不同鏡頭之間的視覺偏差;最後是以上所有內容的導出文件,支持 CSV、Markdown、Excel 和 HTML 格式。這五樣東西是這個 Skill 存在的全部目的,任何中間步驟都是為了最終產出它們。
【第四步:統一結構規範】
分鏡提示詞表按第 X 幕第 X 場景組織,每個場景的提示詞表包含以下字段:鏡頭編號、景別、畫面描述、構圖、運鏡、光線、色調、氛圍、時長、鏡頭角度、提示詞。先生成這個統一的表格模板,後面所有腳本都讀寫這個模板並按此格式輸出。
【第五步:references 內容】
生成以下規範文檔:劇本格式規範、鏡頭術語表、情緒詞庫、提示詞模板、一致性檢查指南。每個文檔獨立成文件,方便後期單獨修改。
【第六步:assets 內容】
基於第四步的結構規範,生成以下可複用模板文件:分鏡 CSV 模板、角色提示詞模板、HTML 導出模板、速查表。
【第七步:劇本解析腳本】
寫一個腳本,能讀劇本文件,分出場景、角色、對白和動作,最後輸出為 JSON 格式。代碼清晰精煉、註釋清楚。
【第八步:角色提取腳本】
從解析結果裏提取角色檔案,包含性別、年齡段、體型、髮型、關鍵詞。為每個角色輸出一段可直接用於 AI 生圖的提示詞描述。
【第九步:場景分析腳本】
從每個場景裏提取地點、室內外、時間段、光線、氛圍,為每個場景生成一條基礎視覺提示詞。
【第十步:分鏡生成腳本】
按場景自動拆成鏡頭,至少包含建立鏡頭、角色出場、對話鏡頭,每個鏡頭嚴格按照第四步定義的字段輸出。
【第十一步:提示詞優化腳本】
對所有鏡頭提示詞做統一處理:術語標準化、去重複、補質量詞、輸出質量打分。參考 references/ 中的提示詞模板和鏡頭術語表。
【第十二步:一致性檢查腳本】
檢查角色跨鏡頭是否漂移、場景是否跳變、光線是否變化突兀,輸出「問題 + 修復建議 + 複用規範提示詞」報告。
【第十三步:導出腳本】
將所有產出內容導出為 JSON、CSV、Markdown 三種格式,HTML 格式基於 assets/ 中的 HTML 模板生成。
【第十四步:測試】
用 2-3 份不同類型的劇本跑全流程,重點檢查:字段是否缺失、鏡頭是否正確生成、提示詞是否符合 references/ 中的規範。發現問題後定位到對應腳本,只修改該腳本,不動其他文件。告訴我每份劇本的測試結果和發現的問題。
【第十五步:封裝 SKILL.md】
基於以上所有內容,生成完整的 SKILL.md 文件,包含:定位說明、觸發方式、完整七步流程說明、輸入要求、輸出目標、文件目錄結構。
---
所有文件生成完畢後,輸出完整目錄結構,以及如何用一份測試劇本跑通全流程的指南。
幾個問題
最開始點樣理清製作一個 Skill 嘅思路?
先捉住一條主線:先諗清楚「用嚟做咩、輸入咩、交付輸出咩」,再將中間步驟拆分(例如解析、生成、檢查、匯出),然後要求統一格式,再叫 AI 輸出。
輕鬆慵懶版嘅次序可以係:提示詞直接要求佢可以透過輸入咩,得到咩輸出,中間流程係點,有邊啲模板可以調用,最後叫 AI 寫腳本。等呢個完成咗,需要咩再補充。咁做唔會一開始就陷進技術細節,亦唔容易做做下跑偏。
有任何唔清楚嘅地方都可以問 AI,由大方向到細化都可以問。例如:
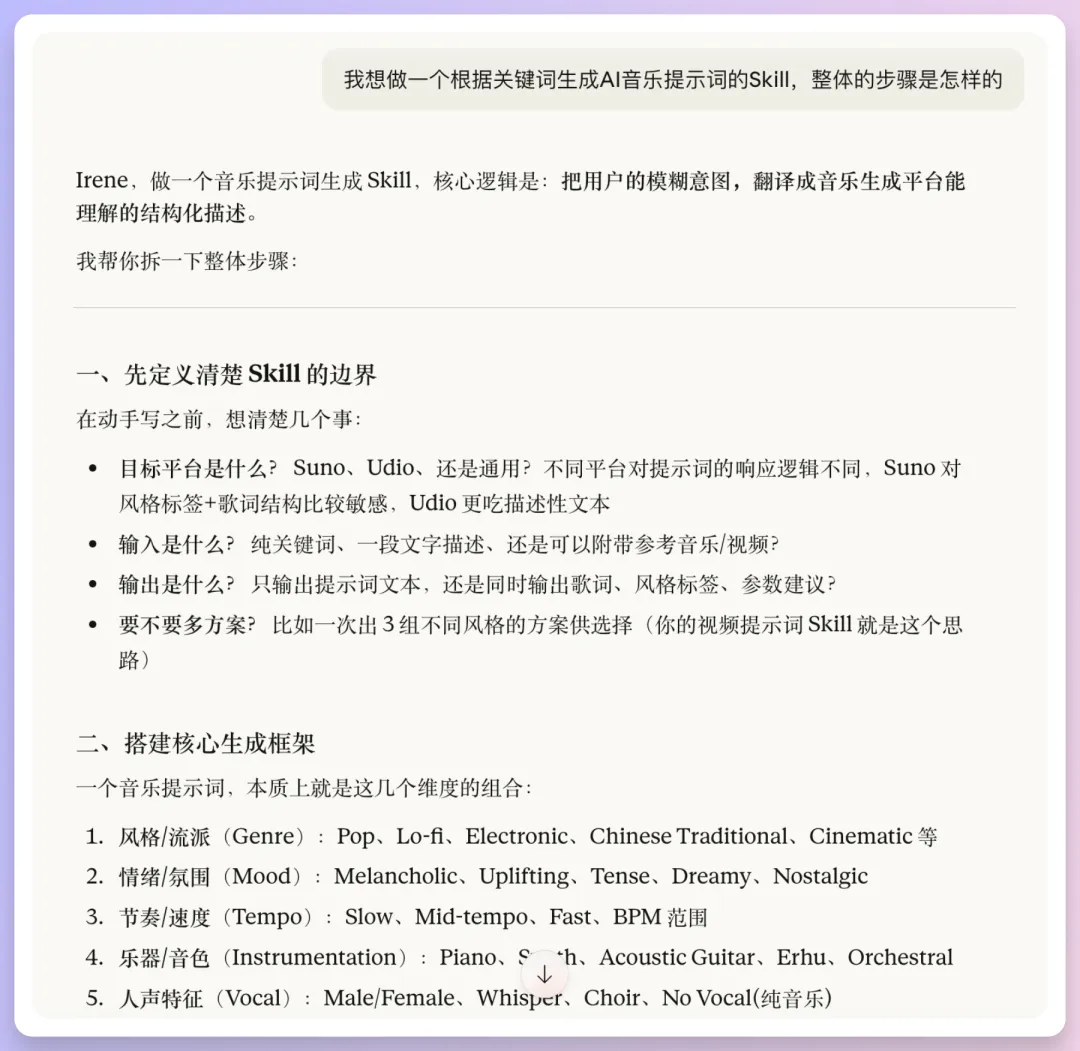
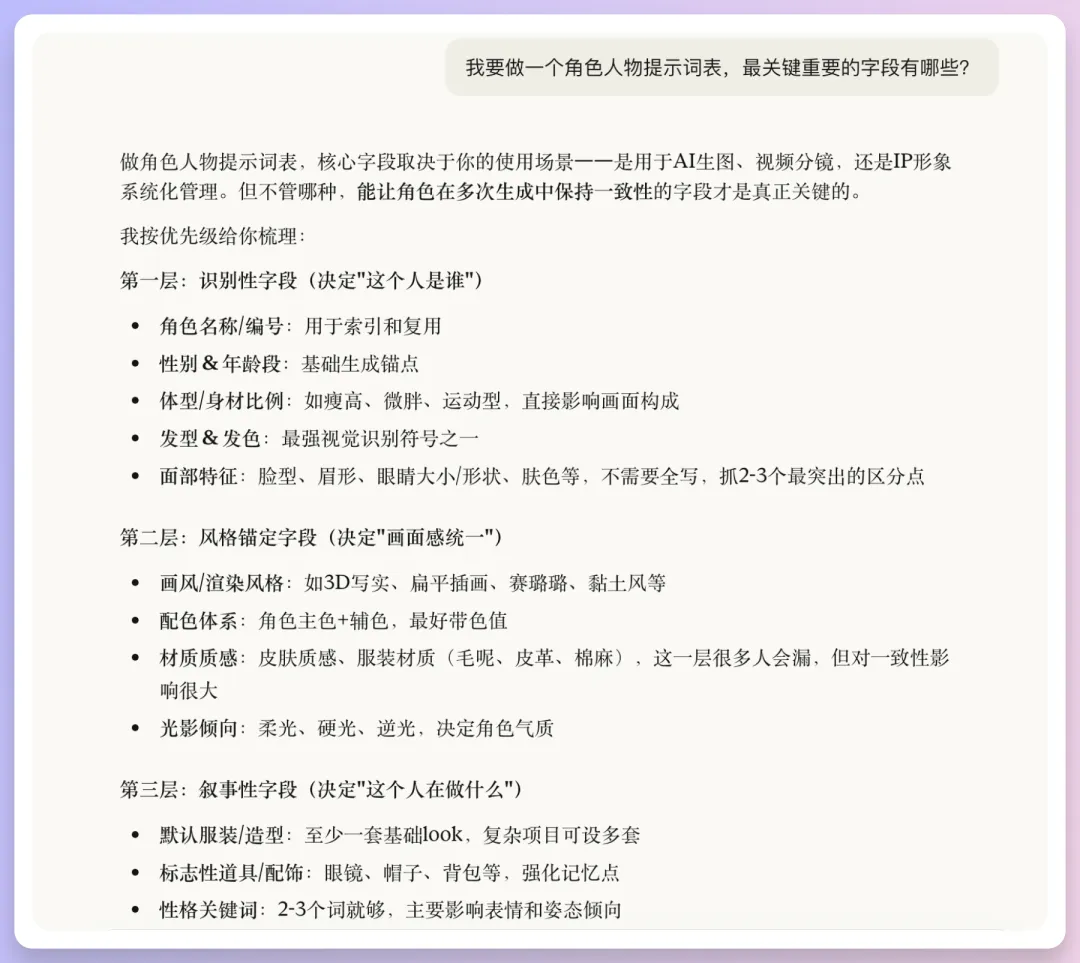
AI 可能會寫得好詳細,我哋提取關鍵要素就得。
再叫 AI 按要求生成 Skill 之前,將要求儘量梳理得全面啲;如果覺得邏輯唔夠清晰或者仲有優化空間,都可以叫 AI 繼續優化提示詞。
點解自動化腳本要單獨抽出嚟?
自動化腳本要單獨抽出嚟,係因為佢同說明文檔、模板資源嘅職責完全唔同:喺呢度,腳本負責執行流程並產出結果,參考文檔負責解釋規則同標準,模板負責規範格式同交付外觀。
點解要分好多個子腳本?
複雜嘅 Skill 入面,將腳本單獨放喺 scripts/,可以令我哋直接調用、測試、替換同部署,唔會被文檔內容幹擾;同時當規則有變,我哋可以只改 references/,當邏輯有變就只改 scripts/,維護成本同排錯成本都會明顯降低。
後期如果要修改內容,點樣要求 AI 去排查同修改,會比較慳 token,而且準確又高效率?
最簡單嘅方法係:每次只叫 AI 做一件小事,並同佢講「只改邊度、唔好亂改、改完點驗收」。你可以直接講:只檢查同修改 scripts/scene_analyzer.py(複製文件路徑)入面嘅光線規則,唔好鬱其他文件;先揾問題點,再做最小改動;最後只話我知改咗邊幾行、會影響咩、點驗證。咁 AI 就唔會周圍讀文件、唔會大改代碼,token 花得少,結果亦更穩。
至於要唔要改 SKILL.md,就取決於改嘅係規則說明定係代碼細節。
小白判斷法:如果用戶使用方式變咗,就改 SKILL.md;如果只係內部實現變咗,可以唔改。
Skill 下載
下載呢個 Skill,可以查看入面所有文件,安裝完就可以直接用:
https://my.feishu.cn/docx/PsPfdVFD9oZ3nZxcvBFcGxdgnje
如果對 Skill 唔夠瞭解,推薦睇我好友 @一澤Eze 呢篇:Agent Skills 終極指南:入門、精通、預測
小結
好啦,今日分享就先到呢度。啱啱復工,感覺個腦都唔係好靈光咁,等有時間再單獨整理 Seedance 2.0 嘅多種提示詞模板同寫法。幾時先可以爽用呀,真係好慢!
題外話,大家最近有冇用 OpenClaw 呀?對佢有咩新睇法?我有幾個問題,歡迎朋友們喺留言區一齊討論:用佢有冇賺到錢,定係純粹花錢?用佢完成嘅任務,其他工具可唔可以代替,定係只有佢先做到?用佢花咗幾多錢,有冇取得咩階段性成果?
期待大家落力三連,下期見!
嗨大家好!我是阿真!新年快樂!
好久不見了,放假給我放爽了,回來猛猛幹活了。今天這篇比較輕鬆,我先復健一下,寫個簡單一點的關於視頻提示詞 Skill 製作的。
上次寫Coze Skill的時候,我曾經分享過一個劇本生成分鏡的Skill,大家可以直接在 Coze 使用,連結在:
https://www.coze.cn/?skill_share_pid=7596234767713173538
也可以直接下載 Skill 文件,文件附件連結我放文章最後的飛書雲文檔連結了。原 Skill 做得比較通用,大家可以在我的基礎上修改。
關於它怎麼使用,我在 Coze Skill 也寫過,就不再贅述,在上面這個 Coze 技能這裏也可以看到使用案例:
或者下載最後的 Skill 文件,上傳到支持 Skill 使用的工具使用也可以:
今天分享這樣的 Skill 怎麼做。
簡單來說思路就是,首先想明白要做什麼,然後將任務一步步拆細,先有整體結構,然後填充枝葉。
完整的 Skill 結構是這樣的:
上面幾個結構的說明👇
SKILL.md:定義這個 Skill 的定位與入口,說明怎麼觸發、整體流程、輸入要求、輸出目標。 這個可以自己寫一個雛形,然後和 AI 工具溝通並優化。
scripts/:執行層,這裏放的 Python 自動化腳本,它負責把流程真正跑起來(解析、提取、生成、優化、導出等)。這個可以給到流程思路讓AI來寫。
references/:知識規範層,提供術語、模板、規則和方法,保證結果統一、可解釋、可複用。類似知識庫,可以把往常使用的格式規範放進來,並且在需要生成具體某個部分的內容的時候,要求它按照這個規範輸出。
assets/:交付模板層,提供可直接套用的資源文件(如 HTML/CSV/JSON 模板與速查表)。它可以提高交付速度和統一性,避免每次從零做格式與排版。
下面是SKILL.md文件,完整 Skill 內容大家可以在文章最後的分享連結去下載查看:
---
name: script-to-video-prompts
description: 短劇劇本轉視頻提示詞生成器。將用戶上傳的短劇劇本文檔智能拆解為可直接用於AI視頻生成的完整中文提示詞體系。輸出包括:角色設定提示詞、場景設定提示詞、逐鏡頭分鏡提示詞。支持批量處理、多格式導出、一致性校驗。當用戶說"劇本轉視頻提示詞"、"拆解劇本生成分鏡"、"短劇轉視頻"、"批量生成分鏡提示詞"、"劇本可視化"時觸發。
---
# 短劇劇本轉視頻提示詞生成器
將短劇劇本文檔智能拆解為可直接用於AI視頻生成的完整中文提示詞體系,支持自動化批量處理。
## 用戶輸入
- 短劇劇本文檔(Word/PDF/TXT/Markdown/Final Draft .fdx)
- 可選:風格參考圖片、角色參考圖片、已有角色設定表
## 工作流程
### 1. 劇本智能解析
使用 `scripts/parse_script.py` 解析劇本:
- 自動識別劇本格式(標準編劇格式/自由格式)
- 提取場次(Scene)、場景描述(Action)、角色對白(Dialogue)、動作指示(Parenthetical)
- NLP分析:情緒曲線、節奏變化、畫面密度
- 自動生成場次時長估算
### 2. 角色設定提取
使用 `scripts/character_extractor.py` 提取角色信息:
- 基礎外貌(年齡、性別、體型、五官特徵)
- 髮型髮色、膚色
- 服裝造型(支持多場次服裝變化追蹤)
- 角色氣質/性格的視覺化表達
- 標誌性道具/配飾
輸出格式參考 [references/character_template.md](references/character_template.md)
### 3. 場景設定分析
使用 `scripts/scene_analyzer.py` 分析場景:
- 場景類型(室內/室外、具體地點)
- 空間結構、關鍵道具佈置
- 光線設計(光源類型、方向、強度、色温)
- 色彩基調、視覺氛圍
- 天氣/時間/季節
輸出格式參考 [references/scene_template.md](references/scene_template.md)
### 4. 分鏡提示詞生成
使用 `scripts/storyboard_generator.py` 生成分鏡:
- 鏡頭編號(場次-鏡號)
- 景別(大特寫/特寫/中近景/中景/中遠景/遠景/大遠景),詳見 [references/shot_terminology.md](references/shot_terminology.md)
- 畫面構圖(三分法位置、視線引導)
- 角色動作、表情、站位
- 運鏡方式(固定/推/拉/搖/移/跟等),詳見 [references/shot_terminology.md](references/shot_terminology.md)
- 情緒氛圍關鍵詞,詳見 [references/mood_keywords_library.md](references/mood_keywords_library.md)
- 建議時長(秒)
- 轉場方式
### 5. 一致性校驗
使用 `scripts/consistency_checker.py` 校驗:
- 角色跨鏡頭一致性控制
- 場景連續性檢查
- 光影風格統一性校驗
- 詳見 [references/consistency_control.md](references/consistency_control.md)
### 6. 導出
使用 `scripts/export_utils.py` 導出:
- 支持格式:Markdown/JSON/CSV/Excel
- 支持按場次/角色/場景分類導出
- 可生成可視化分鏡腳本
## 輸出結構
```
一、項目元數據
   - 片名、集數、總時長、場次數
二、風格總設定
   - 畫面風格、色彩體系、光影風格
三、角色設定庫
   - JSON結構化數據 + 自然語言描述
四、場景設定庫
   - JSON結構化數據 + 自然語言描述
五、完整分鏡提示詞
   - 按場次順序排列,提示詞全部使用中文
六、一致性參考表
   - 角色/場景一致性種子詞
```
## 參考文件
### scripts/(自動化腳本)
- `parse_script.py` - 劇本解析器
- `character_extractor.py` - 角色信息提取
- `scene_analyzer.py` - 場景分析
- `storyboard_generator.py` - 分鏡生成
- `consistency_checker.py` - 一致性校驗
- `export_utils.py` - 多格式導出
- `prompt_optimizer.py` - 提示詞優化
### references/(規範文檔)
- `screenplay_format_spec.md` - 劇本格式規範
- `character_template.md` - 角色設定模板
- `scene_template.md` - 場景設定模板
- `shot_terminology.md` - 景別/運鏡術語詞典
- `mood_keywords_library.md` - 情緒氛圍關鍵詞庫
- `video_style_guide.md` 視頻風格指南
- `consistency_control.md` - 一致性控制指南
- `prompt_patterns.md` - 高效提示詞模式庫
### assets/(模板資源)
- `storyboard_template.csv` - 分鏡腳本CSV模板
- `export_template.html` - 可視化導出HTML模板
下方【文件結構】是 Skill 的文件結構,它的文件結構中必須有 SKILL.md 文件。YAML頭部、Markdown正文和關鍵要素是SKILL.md 格式規範。(可選)的部分是不固定的,可以是文件也可以是文件夾,文件夾的命名也可以按照自己的要求來👇
製作 Skill 的時候,可以前期制定標準,中期優化功能模塊,後期測試優化與封裝。下面是完整的執行思路,注意下方雖然分了步驟,但是實際生成 Skill 的時候它也可以一次執行所有要求,再根據效果繼續優化調整的。
前期:制定標準
我希望這個 Skill 的工作流程是這樣的:
劇本解析 → 角色提取 → 場景分析 → 分鏡生成 → 提示詞優化 → 一致性檢查 → 導出。
如果沒有具體明確的工作流程要求,後面所有實現都會默認按照這個規範。
確定支持哪些輸入:比如txt/md/docx/pdf/fdx。 同時定義默認輸入是一個劇本文檔,也可以是一段話甚至一句話,但是這樣的話效果和內容走向可能會不太可控;“推薦輸入”可加角色圖參考、風格圖參考、畫幅要求、時長限制。
先寫清楚最終要產出哪些文件:角色設定、場景設定、分鏡提示詞、一致性報告、導出文件格式等,這一步的作用是防止中途越做越偏。
確定每一步輸入輸出長什麼樣。我希望它輸出分鏡表是什麼樣的,希望它輸出角色設計提示詞格式是什麼樣的等等。這一步很關鍵,每個輸出項的字段先定好,再讓 AI 按要求輸出,後面就不會亂。
比如我希望完整的分鏡提示詞表是按照第 X 幕第 X 場景,每個場景的提示詞表包含鏡頭編號、景別、畫面描述、構圖、運鏡、光線、色調、氛圍、時長、鏡頭角度、提示詞等。那麼我可以自己做或者讓AI來生成這樣一個統一的表格模板,如果本身有這樣的模板,也可以直接放進去。後面的每個腳本都讀寫這個模板,並且按照這個格式輸出,這樣就不會不同幕和場景之間格式互相對不上。
可以製作模板放在 assets 裏,讓 AI 生成的腳本參考這些模板規範進行生成。
中期:優化功能模塊
references 中存放術語與模板。
整個提示詞的規則可以輸出為單獨的文檔,比如劇本格式規範、鏡頭術語、情緒詞庫、提示詞模板、一致性指南等。這樣會更方便修改和規範指定方向的文檔內容。其他人查看時,也能知道為什麼這麼做。
assets 中存放可複用模板內容。
比如:分鏡 CSV 模板、角色提示詞模板、HTML 模板、速查表等等。這樣每次新項目也能直接複用,不用重做排版和字段。
references 和 assets 中的內容建議單獨生成、優化,輸出文件後放進去,再給到指定路徑給後續腳本調用。
接下來的 7-12 幾個模塊都是腳本,這些都可以讓 AI 來寫。比如 7 的提示詞參考如下:
幫我生成腳本,用於把原始劇本內容(支持 `txt/md/docx/pdf/fdx`)解析成結構化 JSON,要求自動識別並分類:場景標題(INT/EXT 或“第X場/場景X”)、角色名、對白、動作、轉場,並輸出中文字段:`標題`、`場景列表`、`全角色`、`全地點`、`總時長秒數`、`元數據`(含`場景數`、`角色數`、`地點數`),其中每個場景至少包含`場景編號`、`場景標題`、`地點`、`時間段`、`內外景`、`角色`;規則是“上一行是角色名則下一行優先判定為對白,否則判定為動作”,沒有場景標題時自動創建默認場景,空行跳過;重點先保證穩健性和通用性,不追求複雜算法,優先做到“任何劇本或任意文本內容都能讀入並形成場景列表”;支持通過命令行傳入文件路徑並輸出格式化 JSON,代碼儘量清晰、註釋簡單、依賴缺失時提示安裝。更簡單點(自己直接寫),這樣寫不滿意的話可以在這個基礎上讓 AI 優化提示詞:
生成一個通用劇本解析腳本,能讀取常見文本格式並智能分析內容,自動識別場景、角色、對白、動作和轉場,輸出清晰的結構化 JSON;要求優先保證穩定可用,即使輸入不規範也能自動補默認場景並正常返回結果。現在的 AI 工具都很機靈了,我們只要要求它生成 Skill 的時候生成單獨的腳本,它就會自己生成。大多數時候都不需要單獨輸入提示詞。
7. 實現【劇本解析】模塊
把原始劇本變成結構化數據。識別生成場景標題、角色名、對白、動作、轉場。
8. 實現【角色提取】模塊
從【7】的解析結果裏提角色檔案:性別、年齡段、體型、髮型、關鍵詞。要求輸出時給每個角色一段提示詞描述,後面分鏡直接可用,調用也方便。
9. 實現【場景分析】模塊
從【7】的每個場景裏提地點、室內外、時間段、光線、氛圍,給每個場景生成一條基礎視覺提示詞。這一層是全片視覺基礎,後面鏡頭都在它上面疊加。
10. 實現【分鏡生成】模塊
按【7】的場景自動拆成鏡頭,至少包含:建立鏡頭、角色出場、對話鏡頭。每個鏡頭都要有編號、景別、運鏡、動作、時長、轉場、提示詞。先保證“有鏡頭可用”,再逐步優化鏡頭藝術性。
11. 實現【提示詞優化】模塊
把鏡頭提示詞做統一處理:術語標準化、去重複提示詞、補質量詞(提升畫面質量和穩定性的萬能詞,比如高質量、電影感、清晰對焦這類)。這樣能讓輸出更適配視頻模型,不會每條風格都散。有時間的話還可以針對不同風格單獨製作不同風格、不同視頻模型的提示詞規範表。
12. 實現【一致性檢查】模塊
檢查角色跨鏡頭提示詞、場景是否跳變、光線是否變化突兀等,輸出“問題 + 修復建議 + 複用規範提示詞”。
後期:測試優化與封裝
確認默認導出格式,這裏我希望至少支持 JSON + CSV + Markdown。目標是讓不同職能都能直接看和用。
用 2-3 份不同的劇本跑全流程。這個劇本可以 AI 生成也可以自己提供。
重點檢查:字段是否缺失、鏡頭是否正確、提示詞是不是符合自己的要求。
重要的部分可以單獨拎出來補充單獨文檔和腳本,比如我對視頻提示詞有指定的要求,那麼可以單獨一個提示詞參考文檔(放在 references )或提示詞格式參考模板(放在 assets )並要求腳本在指定場景調用。
發現問題就讓 AI 針對對應模塊修改。
最後整理為清晰目錄,最簡單的可以就一個SKILL.md,複雜一些就可以加上腳本、參考、模板等文件夾了,我這裏的格式是:
SKILL.md + scripts/ + references/ + assets/。
這個直接讓 AI 封裝Skill然後自己確認就可以。到這一步,我們就擁有一個比較完整的 Skill 了。
梳理完全部步驟後,就可以輸出一個完整的提示詞,讓 AI 生成 Skill 了。需要詳細輸出的地方,可以單獨生成提示詞或模板後放進去,要求腳本調用。
下面我放了最初我的提示詞要求,後期對這組提示詞進行了分佈的詳細優化,但是我的 Claude 賬號被封了所以優化提示詞的過程沒有了😅,但大致的邏輯思路是上面這樣的,供大家參考。另外,references/ 和 assets/ 中的內容也建議通過對話多輪優化到自己滿意的效果。
你是一個 Skill 開發助手,幫我從零構建一個「劇本轉視頻分鏡提示詞」Skill。請按以下規格和順序執行,不可跳步,不可合併步驟。

---
【第一步:工作流程定義】
這個 Skill 的工作流程是:先解析劇本結構,識別出幕、場景、對白和動作描述;然後提取所有角色,為每個角色生成設定;接着分析所有場景,為每個場景生成設定;再把每個場景拆解成具體鏡頭,生成分鏡提示詞表;之後對每條提示詞做優化,確保它足夠具體、包含必要的視覺參數、並且與角色和場景設定一致;然後做一致性檢查,交叉比對角色、場景與分鏡之間的偏差;最後按用戶要求的格式導出。不可以跳步,不可以合併步驟。如果用戶沒有特別要求改變流程,永遠執行完整的七步。
【第二步:輸入規格定義】
支持接收 txt、md、docx、pdf 和 fdx 格式的劇本文件。最低可運行的輸入是一個劇本文檔,哪怕只是一段話甚至一句核心概念也能啓動流程,但必須在開始前告訴用戶:當前輸入信息有限,後續生成內容的風格一致性和走向可能不完全可控,建議補充更多信息。推薦的輸入是劇本加上角色參考圖、風格參考圖、目標畫幅比例、目標時長、以及希望的視覺風格關鍵詞。用戶提供的參考圖永遠優先於自己的推斷。
【第三步:最終產出定義】
最終產出:一份角色設定文檔,包含每個角色的外貌、服裝、氣質關鍵詞和可用於 AI 生圖的完整提示詞;一份場景設定文檔,包含每個場景的空間描述、光線類型與方向、主色調和氛圍詞;一份完整的分鏡提示詞表,按照幕、場景、鏡頭三級結構組織;一份一致性檢查報告,標註角色和場景在不同鏡頭之間的視覺偏差;最後是以上所有內容的導出文件,支持 CSV、Markdown、Excel 和 HTML 格式。這五樣東西是這個 Skill 存在的全部目的,任何中間步驟都是為了最終產出它們。
【第四步:統一結構規範】
分鏡提示詞表按第 X 幕第 X 場景組織,每個場景的提示詞表包含以下字段:鏡頭編號、景別、畫面描述、構圖、運鏡、光線、色調、氛圍、時長、鏡頭角度、提示詞。先生成這個統一的表格模板,後面所有腳本都讀寫這個模板並按此格式輸出。
【第五步:references 內容】
生成以下規範文檔:劇本格式規範、鏡頭術語表、情緒詞庫、提示詞模板、一致性檢查指南。每個文檔獨立成文件,方便後期單獨修改。
【第六步:assets 內容】
基於第四步的結構規範,生成以下可複用模板文件:分鏡 CSV 模板、角色提示詞模板、HTML 導出模板、速查表。
【第七步:劇本解析腳本】
寫一個腳本,能讀劇本文件,分出場景、角色、對白和動作,最後輸出為 JSON 格式。代碼清晰精煉、註釋清楚。
【第八步:角色提取腳本】
從解析結果裏提取角色檔案,包含性別、年齡段、體型、髮型、關鍵詞。為每個角色輸出一段可直接用於 AI 生圖的提示詞描述。
【第九步:場景分析腳本】
從每個場景裏提取地點、室內外、時間段、光線、氛圍,為每個場景生成一條基礎視覺提示詞。
【第十步:分鏡生成腳本】
按場景自動拆成鏡頭,至少包含建立鏡頭、角色出場、對話鏡頭,每個鏡頭嚴格按照第四步定義的字段輸出。
【第十一步:提示詞優化腳本】
對所有鏡頭提示詞做統一處理:術語標準化、去重複、補質量詞、輸出質量打分。參考 references/ 中的提示詞模板和鏡頭術語表。
【第十二步:一致性檢查腳本】
檢查角色跨鏡頭是否漂移、場景是否跳變、光線是否變化突兀,輸出「問題 + 修復建議 + 複用規範提示詞」報告。
【第十三步:導出腳本】
將所有產出內容導出為 JSON、CSV、Markdown 三種格式,HTML 格式基於 assets/ 中的 HTML 模板生成。
【第十四步:測試】
用 2-3 份不同類型的劇本跑全流程,重點檢查:字段是否缺失、鏡頭是否正確生成、提示詞是否符合 references/ 中的規範。發現問題後定位到對應腳本,只修改該腳本,不動其他文件。告訴我每份劇本的測試結果和發現的問題。
【第十五步:封裝 SKILL.md】
基於以上所有內容,生成完整的 SKILL.md 文件,包含:定位說明、觸發方式、完整七步流程說明、輸入要求、輸出目標、文件目錄結構。
---
所有文件生成完畢後,輸出完整目錄結構,以及如何用一份測試劇本跑通全流程的指南。
幾個問題
最開始怎麼理清製作一個 Skill 的思路?
先抓一條主線:先想清楚“用來做什麼、輸入什麼、交付輸出什麼”,再把中間步驟進行拆分(比如解析、生成、檢查、導出),然後要求統一格式,再讓 AI 輸出。
輕鬆慵懶版順序可以是:提示詞直接要求它可以通過輸入什麼,獲得什麼輸出,中間的流程是怎樣的,有哪些模板可以調用,最後讓 AI 寫腳本。等這個完成了,需要什麼再補充。這樣做不會一開始就陷入技術細節,也不容易做着做着跑偏。
有任何不清楚的地方都可以問 AI,從大方向到細化都可以問。比如:
AI可能會寫得很詳細,我們提取關鍵要素就可以。
再讓 AI 按要求生成 Skill 之前把要求儘可能梳理全面,感覺邏輯不夠清晰或者還有優化空間,都可以讓 AI 去繼續優化提示詞。
為什麼自動化腳本要單獨出來?
自動化腳本要單獨出來,是因為它和說明文檔、模板資源的職責完全不同:在這裏,腳本負責執行流程併產出結果,參考文檔負責解釋規則和標準,模板負責規範格式和交付外觀。
為什麼要分很多個子腳本?
複雜的 Skill 中,把腳本單獨放在 scripts/,可以讓我們直接調用、測試、替換和部署,不會被文檔內容干擾;同時當規則變化時,我們可以只改 references/,當邏輯變化時只改 scripts/,維護成本和排錯成本都會明顯降低。
後期如果要修改內容,怎麼要去要求 AI 去排查和修改比較節省 token ,並且準確高效率?
最簡單的方法是:每次只讓 AI 幹一件小事,並告訴它“只改哪裏、不要亂改、改完怎麼驗收”。你可以直接說:只檢查並修改 scripts/scene_analyzer.py(複製文件路徑) 裏的光線規則,別動其他文件;先找問題點,再最小改動;最後只告訴我改了哪幾行、會影響什麼、怎麼驗證。這樣 AI 不會到處讀文件、不會大改代碼,token 花得少,結果也更穩。
至於要不要改 SKILL.md,取決於改的是規則說明還是代碼細節。
小白判斷法:如果用戶使用方式變了,就改 SKILL.md;如果只是內部實現變了,可以不改。
Skill下載
下載這個 Skill ,可以查看內部所有文件,安裝即可直接使用:
https://my.feishu.cn/docx/PsPfdVFD9oZ3nZxcvBFcGxdgnje
如果對 Skill 不夠了解,推薦閲讀我好友@一澤Eze的這篇:Agent Skills 終極指南:入門、精通、預測
小結
好啦今天的分享就先到這裏,剛恢復開工感覺腦子不是很靈光的樣子,等有時間單獨整理 Seedance 2.0 的多種提示詞模板及其寫法。幾時才能爽用啊真的好慢!
題外話,大家最近使用 OpenClaw 了嗎?對它有什麼新的看法嗎?我有幾個問題,歡迎朋友們評論區一起討論,用它賺到錢了嗎還是純花錢?用它完成的任務其他工具可以替代完成,還是隻有它可以做到?用它花了多少錢了,取得了什麼階段性成果了嗎?
期待大家的猛猛三連,下期見!